


Modelli predittivi e Codice della crisi: una validazione empirica su PMI italiane
Abstract
Il lavoro verifica se un insieme essenziale di indici di bilancio sia in grado di anticipare di dodici mesi l’accesso di una PMI italiana a una procedura concorsuale, in coerenza con l’orizzonte prospettico previsto dall’art. 2, comma 1, lett. a, e dall’art. 3 CCII. Su un campione di 25.577 PMI (201.923 bilanci, 2015-2022) tratto dal database AIDA sono stati stimati tre modelli, regressione logistica, decision tree e random forest, utilizzando cinque variabili esplicative. Sul test set, costruito con matching per dimensione e mantenuto separato dalle fasi di addestramento, i tre modelli raggiungono un’AUC-ROC compresa tra 0,968 e 0,978. In tutti i modelli i predittori dominanti sono la redditività operativa, la solidità patrimoniale e la copertura dell’attivo. Il confronto con gli score di Altman e Bottani mostra che questi ultimi conservano un richiamo elevato ma una precisione inferiore. La regressione logistica è indicata come modello operativo preferibile per interpretabilità e semplicità di implementazione negli adeguati assetti.
1. Introduzione
Il Codice della crisi d’impresa e dell’insolvenza (d.lgs. 14/2019) definisce la crisi come lo stato del debitore che rende probabile l’insolvenza e che si manifesta con l’inadeguatezza dei flussi di cassa prospettici a far fronte alle obbligazioni nei successivi dodici mesi (art. 2, comma 1, lett. a). L’art. 3 impone all’imprenditore assetti organizzativi, amministrativi e contabili idonei a rilevare tempestivamente gli squilibri e a valutare la sostenibilità dei debiti e la continuità aziendale nello stesso orizzonte. Il Codice non prescrive modelli statistici, ma richiede un’attività di diagnosi prospettica che, per le imprese di minori dimensioni, può trovare supporto in strumenti quantitativi analoghi a quelli consolidati nella prassi bancaria (scoring, rating interni, stime di probabilità di default) [1, cap. 1].
La letteratura sulla previsione dell’insolvenza, da Beaver (1966) e Altman (1968) a Ohlson (1980) e Zmijewski (1984), e in Italia da Alberici (1975) a Bottani, Cipriani e Serao (2004) e Altman, Danovi e Falini (2013), ha prodotto modelli calibrati su contesti, periodi e definizioni di default differenti [1, cap. 2]. La ricerca persegue tre obiettivi: stimare e validare modelli predittivi con orizzonte di dodici mesi su dati di bilancio di PMI italiane; confrontare tecniche econometriche e di machine learning in presenza di forte sbilanciamento di classe; valutare l’integrabilità di tali modelli negli adeguati assetti richiesti dal CCII.
2. Dati e metodologia
2.1 Campione
I dati provengono dal database AIDA (Bureau van Dijk) e coprono gli esercizi 2015-2022, periodo che include fasi cicliche eterogenee (ripresa lenta, espansione 2017-2019, pandemia, inflazione e rialzo dei tassi del 2022) [1, par. 3.1.2]. Dalle 2,3 milioni di società censite sono state selezionate le imprese costituite prima del 2010 e rientranti nella definizione europea di PMI con esclusione delle microimprese (attivo fino a 43 milioni di euro, meno di 250 dipendenti, fatturato tra 2 e 50 milioni), per almeno un esercizio del periodo. L’esclusione delle imprese con dati incompleti e degli outlier oltre il 99° percentile di attivo, dipendenti e fatturato ha prodotto un campione finale di 25.577 imprese e 201.923 osservazioni annuali [1, par. 3.1.3].
2.2 Variabile dipendente
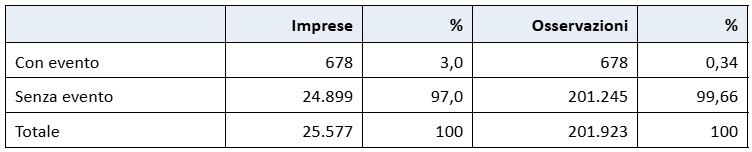
La variabile dipendente è dicotomica e assume valore 1 se l’impresa accede a una procedura concorsuale (“evento giuridico”) nell’anno t+1, condizionatamente ai dati di bilancio dell’anno t. Il lead time di dodici mesi replica l’orizzonte normativo; nella prassi, poiché il bilancio dell’esercizio t è disponibile tra marzo e aprile di t+1, l’anticipo effettivo è di circa otto-nove mesi [1, par. 3.1.4]. Gli eventi osservati sono 678, pari al 3% delle imprese e allo 0,34% delle osservazioni: 527 concordati preventivi, 102 accordi di ristrutturazione, 49 altre procedure. Il numero contenuto di fallimenti (5) è riconducibile alla rilevazione del solo primo evento, a possibile survivorship bias del database e ai filtri di completezza dei dati.
Tabella 1. Composizione del campione [1, tab. 7]
2.3 Variabili esplicative
Le variabili sono state selezionate in base alla letteratura, alla disponibilità nel database e all’analisi di correlazione e multicollinearità [1, par. 3.2]:
- indice di solidità patrimoniale: utili non distribuiti (riserve e utili/perdite cumulati) su totale passività;
- incidenza del costo del personale sul valore della produzione;
- indice di copertura dell’attivo: capitale circolante netto su attivo totale;
- ROA: risultato operativo su attivo totale;
- logaritmo naturale dell’attivo totale, come controllo per la dimensione.
2.4 Stima e validazione
Il training set comprende tutte le osservazioni originarie del dataset; lo sbilanciamento di classe è stato trattato su questo campione con la tecnica SMOTE (Chawla et al., 2002), con k = 5, che genera osservazioni sintetiche della sola classe minoritaria, mentre oversampling e undersampling casuali sono stati impiegati come termini di confronto [1, par. 3.3-3.4.1]. Il training set bilanciato comprende 402.490 osservazioni, di cui 200.567 sintetiche. Il test set è stato costruito con una logica di matching mirato anziché per campionamento casuale: per ciascuna delle 678 imprese con evento nell’anno successivo per ciascuna delle 678 imprese con evento nell’anno successivo sono state selezionate le due imprese senza evento più prossime per valore dell’attivo (k-nearest neighbours, k = 2), per un totale di 2.034 osservazioni, in modo da impedire ai modelli di discriminare sulla sola dimensione e rendere la verifica più severa [1, par. 3.4.2]. I modelli sono stati stimati con cross-validation a cinque blocchi sul training set bilanciato, con standardizzazione delle variabili calcolata sui soli dati di addestramento di ciascun ciclo per evitare data leakage e ricerca degli iperparametri con massimizzazione dell’AUC; il modello con la configurazione migliore è stato riaddestrato sull’intero training set e valutato sul test set, mantenuto separato dalle fasi di addestramento [1, par. 3.4.3]. I tre modelli stimati sono regressione logistica, decision tree (profondità massima 4) e random forest (200 alberi) [1, par. 3.5 e cap. 4].
3. Risultati
3.1 Regressione logistica
L’equazione stimata nello spazio del logit è:
logit(p) = −3,8334 − 2,8023 · Indice_Solid + 1,3793 · Inc_Pers − 2,5807 · Ind_Cop_Att − 13,2248 · ROA + 0,377 · log_attivo
Tutti i coefficienti sono significativi (p < 0,001) e presentano il segno atteso: redditività, solidità e copertura dell’attivo riducono la probabilità di evento, l’incidenza del personale la aumenta. Il coefficiente positivo della dimensione, di entità contenuta, è attribuito nella tesi a effetti di composizione del campione e del matching [1, par. 4.1.1]. L’AUC-ROC sul test set è 0,968; alla soglia F1-ottimale (0,513) precision e recall sono pari a 0,934 e 0,898 [1, par. 4.1.2-4.1.3]. Un esempio applicativo presentato in sede di discussione illustra la lettura dell’equazione: per un’impresa con indice di solidità 0,078, incidenza del personale 0,176, copertura dell’attivo −0,063, ROA −0,094 e logaritmo dell’attivo 10,71, calcolati sul bilancio 2023, il logit vale 1,63 e la probabilità stimata di evento nell’anno successivo è dell’84%; l’impresa ha poi avviato la composizione negoziata nel 2024 e successivamente un concordato preventivo [11].
3.2 Confronto tra modelli
Tabella 2. Prestazioni sul test set alla soglia F1-ottimale [1, tab. 25]
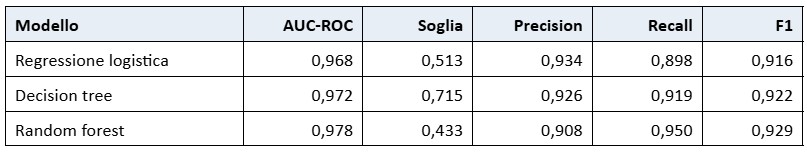
La random forest ottiene i valori più elevati di AUC e F1; la regressione logistica conserva la precisione più alta. La gerarchia delle variabili è stabile tra i tre modelli: nella logistica il ROA ha il coefficiente standardizzato più elevato in valore assoluto, seguito da solidità e copertura dell’attivo; nella random forest l’indice di solidità pesa per il 48% dell’importanza complessiva e il ROA per il 30%, ordinamento confermato dall’analisi SHAP (0,269 e 0,136) [1, tab. 23 e 26]. Dimensione e incidenza del personale contribuiscono in misura marginale.
3.3 Confronto con gli score di Altman e Bottani
Sul medesimo test set lo Z’ di Altman colloca in zona distress 644 delle 678 imprese con evento, ma anche 207 delle 1.356 imprese senza evento, con altre 839 in grey area; lo score di Bottani assegna alla classe distress 637 imprese con evento e 104 senza evento, classificando come safe 933 imprese in bonis [1, par. 5.1-5.2]. Con una soglia di classificazione uniforme, i risultati sono i seguenti.
Tabella 3. Confronto con soglia uniforme [1, tab. 27]
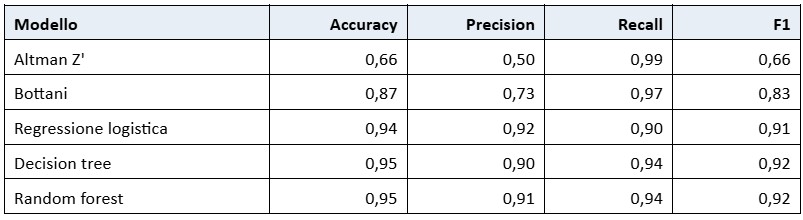
La binarizzazione degli score storici è una semplificazione adottata ai soli fini comparativi [1, par. 5.4]. Gli score tradizionali privilegiano il richiamo a scapito della precisione; i modelli stimati migliorano simultaneamente entrambe le misure.
4. Discussione e implicazioni operative
I risultati rispondono in modo netto alla domanda di ricerca. Un insieme di cinque indicatori, calcolabili da qualsiasi bilancio depositato, discrimina con elevata affidabilità, dodici mesi prima dell’evento, le PMI che accederanno a una procedura concorsuale: l’AUC-ROC è compresa tra 0,968 e 0,978 e, alla soglia ottimale, i modelli intercettano tra il 90% e il 95% degli eventi mantenendo la quota di falsi allarmi tra il 3% e il 5% delle imprese sane [1, cap. 4]. Il risultato è ottenuto su un campione di 25.577 imprese e otto esercizi che includono la pandemia e lo shock inflattivo del 2022, e su un test set costruito per essere difficile, nel quale ogni impresa in crisi è confrontata con imprese della stessa dimensione: la capacità discriminante non dipende quindi dalla scala aziendale né da un solo ciclo economico.
Il secondo risultato è la convergenza tra tecniche. Regressione logistica, decision tree e random forest, pur con logiche di stima diverse, individuano la stessa gerarchia di fattori: redditività operativa, solidità patrimoniale e copertura dell’attivo. Questa stabilità è un’evidenza in sé, perché mostra che i segnali di deterioramento sono strutturali e non un artefatto del metodo, e fornisce una base quantitativa, su larga scala, a quanto la dottrina aziendalistica e la prassi professionale indicano da tempo sul piano qualitativo [1, par. 6.1].
Il terzo risultato riguarda il confronto con gli score storici. Sullo stesso test set lo Z’ di Altman e il modello di Bottani conservano un richiamo elevato ma una precisione nettamente inferiore (0,50 e 0,73 contro 0,90-0,92 dei modelli stimati): intercettano le imprese in crisi al prezzo di segnalare come rischiose molte imprese sane [1, tab. 27]. I modelli calibrati su dati italiani recenti utilizzano l’informazione disponibile in modo più efficiente e consentono di regolare il trade-off tra falsi positivi e falsi negativi in funzione di chi usa lo strumento.
Sul piano applicativo, la tesi indica la regressione logistica come modello operativo. Il differenziale di AUC rispetto alla random forest è di circa 0,010, mentre l’equazione logistica è scrivibile su una pagina, implementabile in un foglio di calcolo e spiegabile a imprenditori e organi di controllo in termini di effetto di ciascuna variabile sulla probabilità di crisi [1, par. 4.5 e 6.2]. È un requisito sostanziale per uno strumento che deve entrare negli adeguati assetti ex art. 3 CCII e reggere il confronto con sindaci, revisori e banche. La random forest mantiene la funzione di controllo periodico, per rilevare l’eventuale emergere di relazioni non lineari nei nuovi dati.
Per le imprese, il modello è una componente degli assetti di allerta interna, complementare alla tesoreria prospettica e al test pratico della composizione negoziata, e offre un indicatore sintetico aggiornabile a ogni chiusura contabile. Per banche e investitori, i risultati indicano con precisione le variabili da presidiare prima che compaiano scaduti e segnalazioni: redditività operativa e capacità di trattenere utili in azienda.
5. Perimetro del lavoro e sviluppi
Il disegno della ricerca riflette scelte esplicite, che ne definiscono il perimetro. Il test set con rapporto 1:2 tra imprese con e senza evento è stato costruito per verificare la capacità discriminante in condizioni più severe di quelle reali; le metriche vanno quindi lette come misura della capacità di separare i due gruppi a parità di dimensione, mentre l’applicazione su una popolazione in cui gli eventi sono rari richiede la calibrazione della soglia agli obiettivi di chi usa il modello, operazione che la tesi documenta per tre soglie alternative [1, par. 4.1.3 e 6.3]. L’uso esclusivo di dati di bilancio annuali è una scelta di accessibilità: il modello funziona con informazioni pubbliche e disponibili a qualunque impresa, consulente o finanziatore, senza richiedere dati proprietari. L’orizzonte fisso di dodici mesi replica quello normativo.
Gli sviluppi indicati nella tesi partono da questa base. Il primo è l’estensione dinamica, trattando le serie storiche di bilancio come traiettorie e non come osservazioni isolate. Il secondo è l’integrazione di informazioni extra-contabili, in particolare dati di Centrale Rischi, rapporti con Erario ed enti previdenziali e i segnali tipizzati che lo stesso CCII invita a considerare. Il terzo, di maggiore rilievo istituzionale, è la sperimentazione del modello all’interno dei processi di composizione negoziata e degli adeguati assetti: verificare se anticipa l’accesso allo strumento e integrarlo in una reportistica periodica a disposizione di amministratori, esperti e banche, come tassello di un processo di diagnosi condivisa [1, par. 6.4].
La conclusione della tesi è che la distanza tra il linguaggio dei modelli quantitativi e quello del diritto della crisi è minore di quanto appaia: il Codice chiede strumenti capaci di rendere probabile l’individuazione tempestiva della crisi, e i modelli validati su un ampio campione di PMI italiane mostrano di poter svolgere questa funzione [1, par. 6.5].
Riferimenti bibliografici
- Zorzetto, M. (2025). Modelli predittivi e crisi d’impresa: applicazioni nel Codice della crisi, analisi dei casi di accesso a procedure concorsuali e validazione empirica su PMI italiane. Tesi di Master di II livello in Crisi di impresa e ristrutturazioni aziendali, Università degli Studi di Bergamo, relatore A. Danovi, correlatore S. Birolini, a.a. 2024/2025, versione finale 12 ottobre 2025.
- Alberici, A. (1975). Analisi dei bilanci e previsione delle insolvenze. Milano: Isedi.
- Altman, E. I. (1968). Financial Ratios, Discriminant Analysis and the Prediction of Corporate Bankruptcy. Journal of Finance, 23(4), 589-609.
- Altman, E. I. (2000). Predicting Financial Distress of Companies: Revisiting the Z-Score and ZETA Models.
- Altman, E. I., Danovi, A., Falini, A. (2013). Z-Score Models’ Application to Italian Companies Subject to Extraordinary Administration. Bancaria, n. 4, aprile 2013, 24-37.
- Beaver, W. H. (1966). Financial Ratios as Predictors of Failure. Journal of Accounting Research, 4(3), 71-111.
- Bottani, E., Cipriani, A., Serao, A. (2004). La previsione delle insolvenze aziendali: un’applicazione del modello Z-Score alle PMI italiane.
- Chawla, N. V. et al. (2002). SMOTE: Synthetic Minority Over-sampling Technique.
- Ohlson, J. A. (1980). Financial Ratios and the Probabilistic Prediction of Bankruptcy. Journal of Accounting Research, 18(1), 109-131.
- Zmijewski, M. E. (1984). Methodological Issues Related to the Estimation of Financial Distress Prediction Models. Journal of Accounting Research, 22 (suppl.), 59-82.
- Zorzetto, M. (2025). Presentazione della tesi, Master di II livello in Crisi di impresa e ristrutturazioni aziendali, Università degli Studi di Bergamo, 18 dicembre 2025, slide 8.
A cura di:
Marco Zorzetto
20/11/2026
